字节辟谣"群演数据喂大模型":严重失实!
要点导读
- 字节否认使用群演数据训练大模型
- 火山引擎仅为技术支持方
- 数据资产归横店或授权方所有
- 个人肖像声音使用需授权
内容摘要
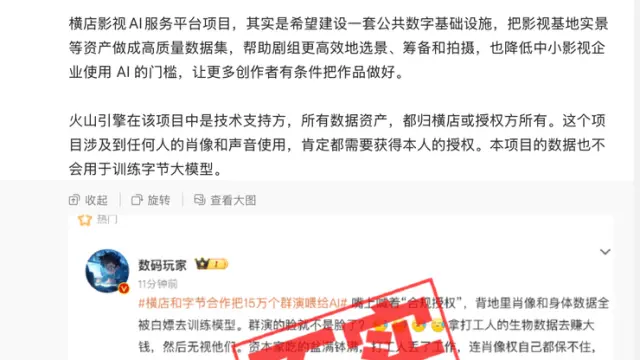
针对网络传言“横店与字节合作将15万名群演肖像和声音喂给字节大模型”,字节豆包公关负责人刘星通过微博回应称严重失实。他澄清火山引擎仅为技术支持方,数据资产归横店或授权方所有,个人肖像声音使用需授权,且数据不会用于训练字节大模型。
阅读原文
原文来源:雷峰网(leiphone.com)。本页摘要与要点整理自公开来源,版权归原作者所有,完整内容请阅读原文。