爱诗科技发布实时世界模型 PixVerse R2,引入规模化 Scaling 思路
R2 基于统一可扩展的世界模型框架,将文字、图像、声音和动作统一进模型,可边生成边响应、音画同步,并保持场景前后一致。
海外一手 AI 动态的中文速览 + 国内 AI 新闻 + 站内原创文章,按发布时间从新到旧排列。资讯摘要整理自公开来源,附原文链接。只收 AI 与科技内容,不收政治、军事等话题。
共 232 条 · 第 3 / 10 页
R2 基于统一可扩展的世界模型框架,将文字、图像、声音和动作统一进模型,可边生成边响应、音画同步,并保持场景前后一致。
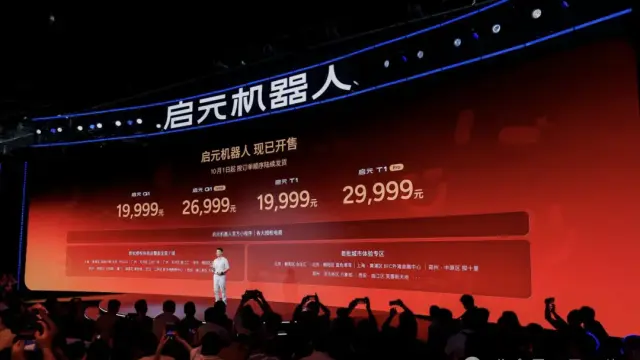
Q1 主打可定制外观、动作与性格,T1 支持人形与四足形态切换;另有开放 SDK 和 HDK 的 Q1 探索版,售价 26999 元。
云栖大会上,阿里宣布千问 AI 平台以推动 Agent 进入生产为核心,新增 Agent 服务和行业解决方案支持;过去一年阿里云 MaaS 平台客户数增长六倍。
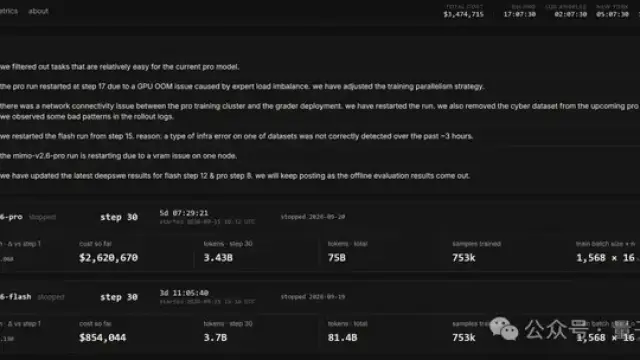
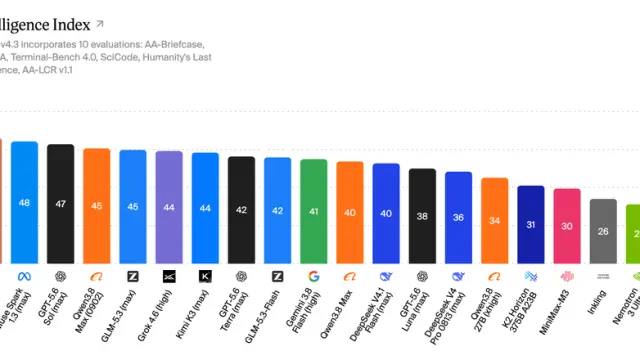
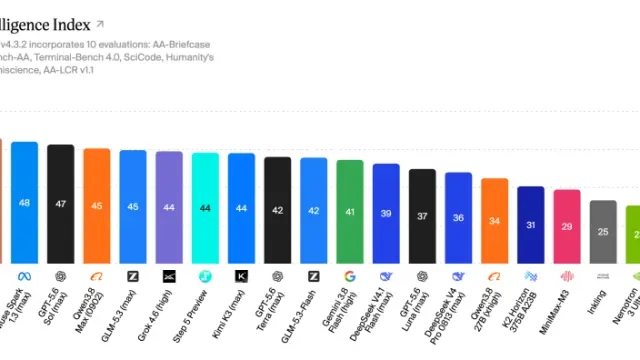
MiMo-V2.6 Pro 和 Flash 跑完 30 个训练 Step,总花费约 350 万美元;Pro 版激活 420 亿参数,在 Artificial Analysis 智能指数上拿到 46 分。
阿里表示基于下一代架构的 Qwen4 已在训练,Qwen4.5、Qwen5 等将扩展到 5 到 10 万亿参数;视频模型 Wan3.0 获 Artificial Analysis 文生视频与视频编辑双榜第一。
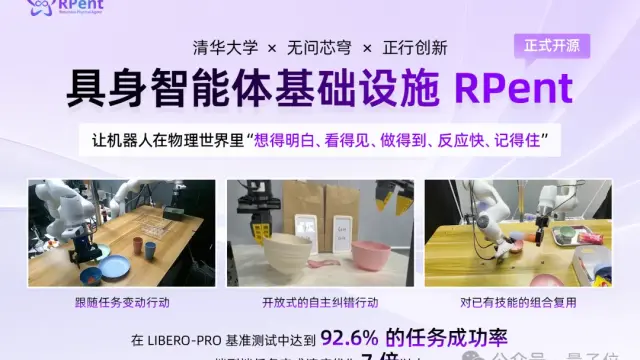
RPent 将通用大模型的任务规划能力、VLA 等专家模型的精细操作、记忆与工具及机器人接口连接起来,形成感知—决策—执行—纠错闭环。
Step 5 Preview 在 Artificial Analysis 智能指数中得到 44 分,位列全球开源模型第二,Agent 能力显著提升。
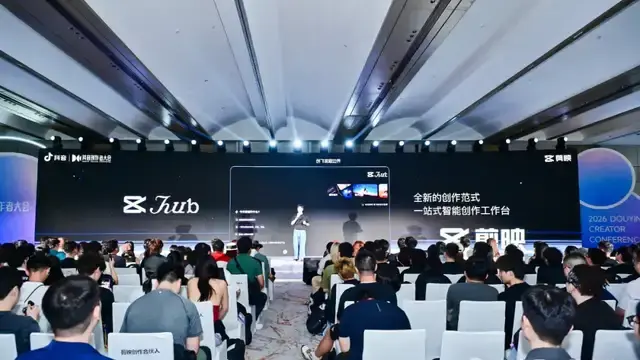
用户可在 AI 视频生成的无限画布中一键跳转到剪映多轨道剪辑界面,并通过分镜脚本、资产管理等模块串联生成流程。
量子位实测 Qwen3.8-27B,称其在 Cerebras 上每秒可输出近 2000 个 token,能根据一句提示直接生成完整前端页面。
文章介绍了把模型知识截止在历史节点、检验其能否做出超越训练数据推理的尝试,如从零训练的 GPT-1900 在多数物理任务上未能成功。
该计划将联合学术界与产业界,为数学与科学研究构建开放权重模型和开源工具,首阶段聚焦理解论证、核对文献和形式化证明等场景。
今年早些时候终止与 Meta 合并的 Manus,正洽谈新一轮 5 亿美元融资,估值 40 亿美元。
唐杰介绍,GLM-5.3 驱动的 Infra Agent 在超 10 万张国产芯片集群上参与搭建并优化推理系统,将 Prefill+KV Transfer 的性能损失从 20% 以上压到 1% 以内。
罗福莉官宣小米强化学习进展,公开 MiMo 新模型训练的花费、步数、奖励曲线和显卡故障等信息;开训 36 小时两款模型已花费超 108 万美元。
该 9B 通用多模态模型在九项空间测试中拿下 10B 规模模型的 8 项第一,同时保持图文理解、OCR、数学推理与代码能力处于第一梯队。
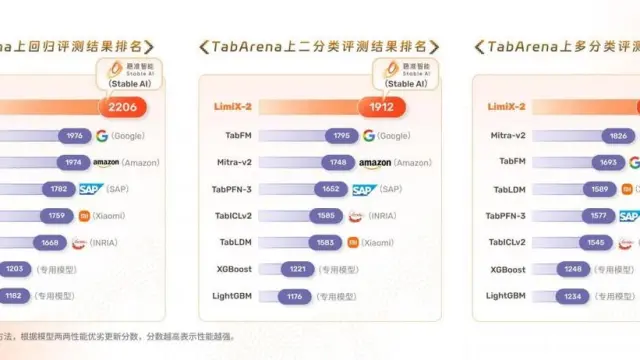
LimiX-2 在 TabArena、BCCO、TALENT 三个结构化数据基准中总体 Elo 分别为 1935、1432 和 1506,均位列榜单第一。
Vidu S2 可让用户与数字人实时互动,并能对正在播放的视频实时换装、换人、换背景和换画风,距上一代 Vidu S1 发布仅约两个月。
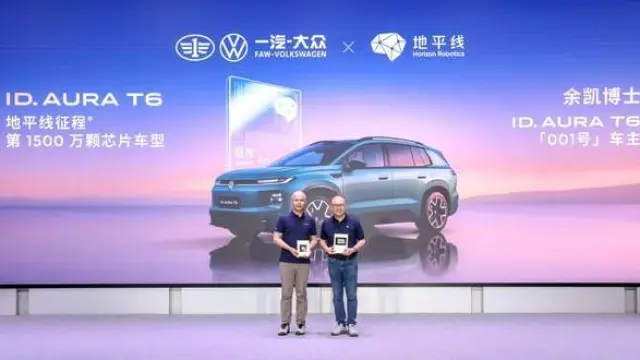
第 1500 万颗征程芯片将搭载于一汽-大众 ID. AURA T6,HSD V2.1 版本即将推出并首发全场景倒车能力。
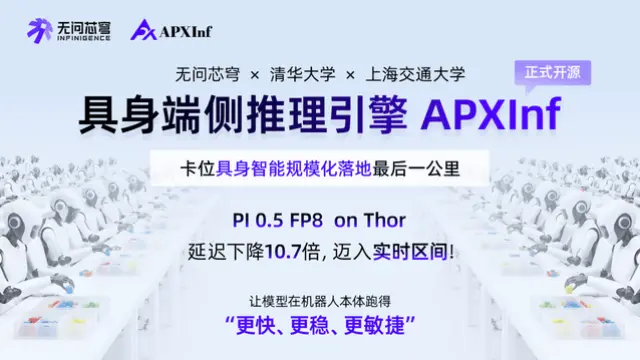
APXInf 面向机器人端侧部署,在 Pi 0.5 模型上取得领先的推理性能。
HD-V1 采用自研原生全模态架构,支持文本、图片、视频等多模态输入,主打符合物理规律的视频生成。
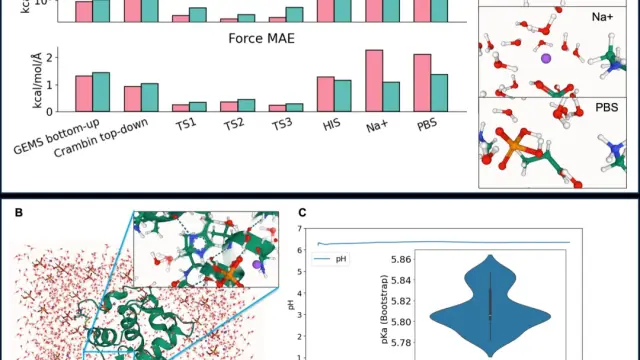
QuantaMind 能以接近量子化学的精度模拟十万原子级体系数百纳秒的反应,相关研究发表于《Science Advances》。
Meta FAIR 与华盛顿大学提出将教师模型的 Token 概率分布转换到字节级进行蒸馏,以 Llama 3-8B 为教师进行了实验。
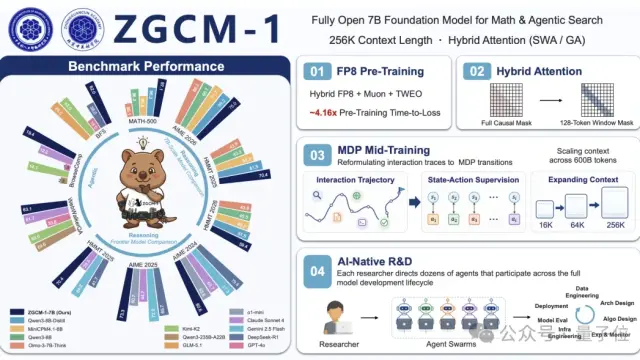
北京中关村学院团队公开了训练数据与配方、权重、代码、中间 checkpoint 和日志,ZGCM-1 在多项通用评测中与 Qwen3-8B 等同规模模型相近。
赛事在外滩大会上启动,旨在将 LingBot-VLA 推向更广泛的开发者和高校科研社区。